
楚河汉界之上:AI 时代的人类护城河
大模型吐出的是概率,现实要的是确定性交付——这条鸿沟不会因为参数变大而消失。本文阐明鸿沟之上正在成为核心资产的五样东西:独特数据、真实闭环、可核验的信任、可归责的责任、可执行的制度,并论证为什么闭环是其中唯一的发动机。
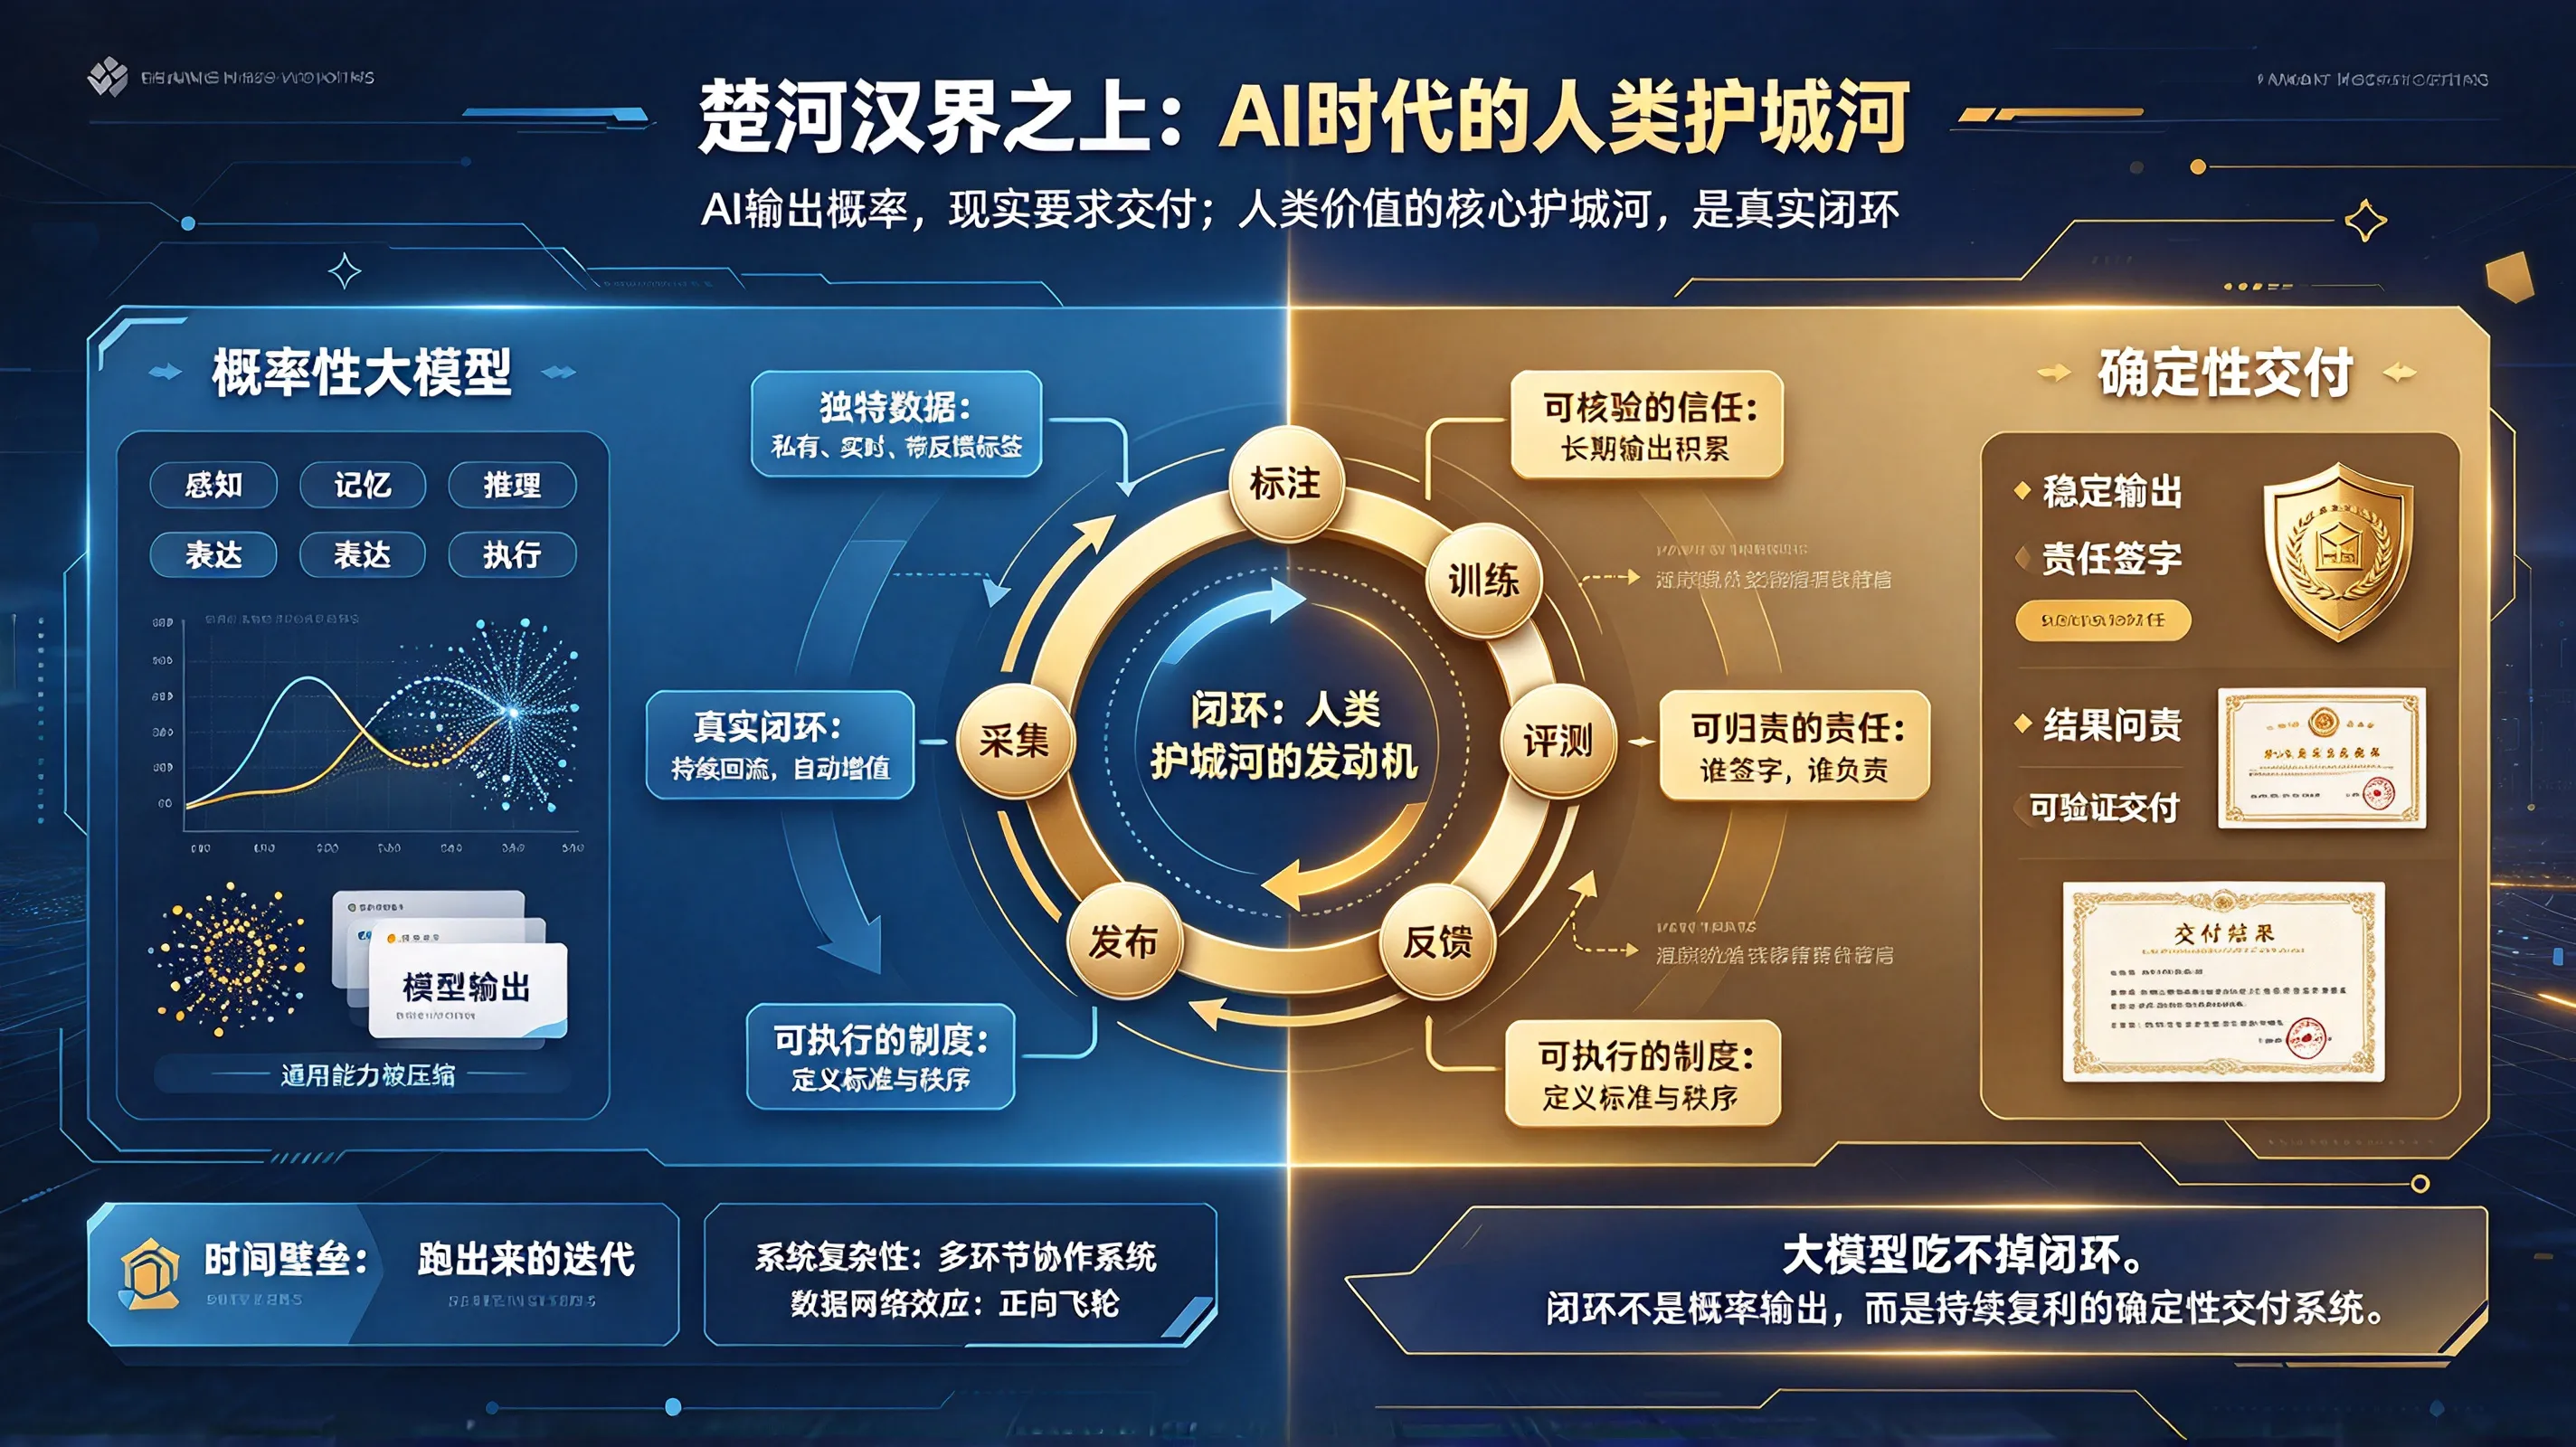
图:左侧是模型的能力区——感知、记忆、推理、表达、执行被压缩成概率分布;中间是楚河汉界:概率 vs 确定性交付;右侧是鸿沟之上的人类护城河——独特数据、真实闭环、可核验的信任、可归责的责任、可执行的制度,其中闭环是驱动其余四者的发动机。
大模型正在做一件前所未有的事:它把人类的感知、记忆、推理、表达和执行,压缩成概率分布。你给它一段需求,它吐出代码;你给它一堆数据,它吐出分析;你给它一个问题,它吐出答案。它不再只是辅助工具,而是开始接管认知劳动本身。
但这里有一条楚河汉界。
模型吐出的永远是概率,而现实世界要求的是确定性交付。代码可以跑通也可以崩溃,分析可以正确也可以误导,建议可以有用也可以致命。模型无法为结果签字,无法承担事故责任,无法在法庭上作证,无法在董事会里被问责。这条鸿沟不会因为模型参数变大而自动消失,反而会随着 AI 能力普及而变得更加显眼——因为当”生成”变得廉价,“交付”才真正稀缺。
在鸿沟之上,五样东西正在成为人类的核心资产:独特数据、真实闭环、可核验的信任、可归责的责任、可执行的制度。其中,闭环是最关键的护城河,因为它是其他四者的发动机。
一、为什么通用能力正在塌陷
过去,一个人的竞争力往往建立在通用能力上:会写代码、会做分析、会写文案、会做设计、会翻译、会编程。这些能力有一个共同特征——它们本质上是”从输入到输出的转换”。而大模型恰恰最擅长做转换。
更残酷的是,这种塌陷不是线性的,而是加速的。模型能力越强,被压缩的通用能力就越多。三年前程序员还在为写 boilerplate 代码自豪,今天 AI 已经能生成完整模块;两年前分析师还在为做图表骄傲,今天模型可以直接读取数据输出洞察。通用能力的半衰期正在急剧缩短。
但这并不意味着人的价值在消失。恰恰相反,价值正在向上迁移——从”完成转换”迁移到”保证交付”。
二、鸿沟之上:五样稀缺资产
独特数据是燃料。大模型吃的是公开互联网数据,而真正有价值的往往是私有的、实时的、结构化的、带反馈标签的数据。车端真实接管数据、医院真实诊疗记录、工厂真实良率数据、企业真实客户对话——这些无法被爬虫获取的数据,才是训练出差异化能力的根基。
真实闭环是发动机。数据本身不会自动变成能力,必须有一个持续回流的机制:采集→标注→训练→评测→发布→反馈→再采集。没有闭环,数据只是仓库里的库存;有了闭环,数据才变成不断进化的资产。
可核验的信任是通行证。在一个 AI 生成内容泛滥的世界里,“这是真的”本身就成了稀缺品。信任不是靠头衔获得,而是靠可验证的长期输出积累:你过去的判断是否准确,你的交付是否可靠,你的承诺是否兑现。
可归责的责任是护城河。模型可以生成方案,但不能为方案负责。谁签字、谁发布、谁对客户负责、谁对事故担责,决定了谁真正拥有决策权。责任是最硬的稀缺资源,因为它无法被外包给概率系统。
可执行的制度是规则制定权。当你能定义一个领域的评价标准、工作方法和协作秩序时,你就从参与者变成了规则制定者。ISO 标准、米其林指南、TOEFL 考试、精益生产——这些都是制度能力的体现。
三、为什么闭环是护城河的核心
这五样资产不是并列的,闭环是发动机。
没有闭环,独特数据只是一次性资产,用完就枯竭;有了闭环,数据会持续回流、自动增值。没有闭环,信任只是静态声誉,经不起一次失误;有了闭环,信任可以通过持续可靠交付不断加固。没有闭环,责任只是风险负担;有了闭环,责任变成可管理的系统工程。没有闭环,制度只是纸上规范;有了闭环,制度可以通过反馈数据持续迭代。
闭环的本质,是把”一次性能力”变成”可复利的系统”。
在自动驾驶领域,这个逻辑已经非常清晰:头部企业之所以领先,不是因为某一代模型更强,而是因为数据闭环跑得更快、更稳、更自动化。真实接管数据回流,自动挖掘难例,自动标注,自动训练,自动仿真评测,自动决定能否 OTA 发布——这个闭环每转一圈,模型就强一分,数据壁垒就高一寸。
这个逻辑可以迁移到任何行业。
一个医生如果只有知识,他会被 AI 辅助诊断挑战;但如果他拥有自己的患者随访闭环——诊断→治疗→随访→结果回流→方案迭代——他的临床能力就会持续进化,形成 AI 无法复制的经验资产。
一个咨询师如果只有方法论,他会被 AI 报告生成器挑战;但如果他拥有客户落地闭环——诊断→方案→执行→效果追踪→方法迭代——他的方法论就会在真实场景中不断校准,形成可验证的交付能力。
一个内容创作者如果只有写作能力,他会被 AI 生成挑战;但如果他拥有读者反馈闭环——发布→互动→数据分析→选题调整→再次发布——他的内容就会越来越贴合真实需求,形成 AI 无法模仿的社群信任。
四、闭环为什么难以复制
闭环的护城河效应来自三个特征。
第一,时间壁垒。 闭环不是设计出来的,是跑出来的。你需要真实数据回流,需要多次迭代,需要积累足够多的反馈标签。这些无法用金钱快速购买,也无法用参数规模直接超越。
第二,系统复杂性。 一个成熟的闭环涉及采集、标注、训练、评测、发布、监控、归因、再采集等多个环节,每个环节都有大量工程细节和领域知识。它不是一个模型,而是一整套协作系统。
第三,数据网络效应。 闭环跑得越久,数据越多;数据越多,模型越强;模型越强,用户体验越好;用户体验越好,数据回流越多。这是一个正向飞轮,后来者很难打破。
五、个人的行动方向
对个体而言,最现实的策略不是恐慌替代,而是尽快把自己从”可被模型压缩的环节”迁移到”能定义问题、整合资源、承担责任、拥有数据或信任关系的位置”。而闭环,是迁移的最佳路径。
你可以从一个小闭环开始:选一个你真正在做的任务,设计它的反馈回流机制,让它每执行一次就变得更聪明一点。可以是你的代码开发流程,可以是你的内容创作流程,可以是客户服务流程,也可以是投资决策流程。
关键不是闭环有多大,而是它是否在真实运转、是否带回反馈、是否在持续迭代。一个每天转一圈的小闭环,远胜于一个永远停留在 PPT 上的大闭环。
结语
AI 能力越普及,通用能力越快地变成基础设施。真正形成差异的,是那些往上走的东西——独特数据、真实闭环、可核验的信任、可归责的责任、可执行的制度。
大模型吃掉了人类的感知、记忆、推理、表达和执行,但它吃不掉闭环。因为闭环不是认知能力,而是系统工程;不是概率输出,而是确定性交付;不是一次性转换,而是持续复利。
在楚河汉界之上,闭环将成为人类价值的护城河。而护城河的深度,取决于你愿意花多少时间,让它一圈一圈地转下去。